
Gestire campagne SEO su più client o progetti complessi rappresenta prima di tutto un problema di gestione del contesto. Ogni sito porta con sé un proprio universo di parole chiave, un debito tecnico specifico, lacune nei contenuti, dinamiche della concorrenza e un flusso ininterrotto di dati provenienti da Google Search Console e strumenti di tracciamento. Tradizionalmente, gli specialisti cercano di dominare questa mole di informazioni alternando fogli di calcolo, segnalibri, note disordinate e uno sforzo mnemonico estenuante che rischia di fallire nei momenti critici. La soluzione a questa frammentazione risiede nella creazione di un Second Brain per la SEO, un sistema esterno e strutturato di conoscenza che conserva il contesto dei progetti e sfrutta l’intelligenza artificiale per trasformarlo in un partner strategico permanente.
Leggi tutto: Come creare un Second Brain per la SEOChe cos’è, come funziona e a cosa serve un SEO Second Brain
Un Second Brain non è una semplice applicazione di note o un archivio passivo di documenti. Si tratta di un’infrastruttura di conoscenza esterna, interrogabile e strutturata al di fuori della singola finestra di chat dei modelli linguistici. Il cervello umano possiede una straordinaria capacità di generare idee originali, connettere concetti e sviluppare il pensiero critico, ma risulta estremamente inefficace nel conservare dettagli precisi, recuperare dati a distanza di tempo o categorizzare grandi volumi di informazioni. Delegare compiti di archiviazione e recupero a un database esterno libera la memoria biologica dal ruolo di archivista, permettendole di concentrarsi su ciò che sa fare meglio: pensare e decidere.
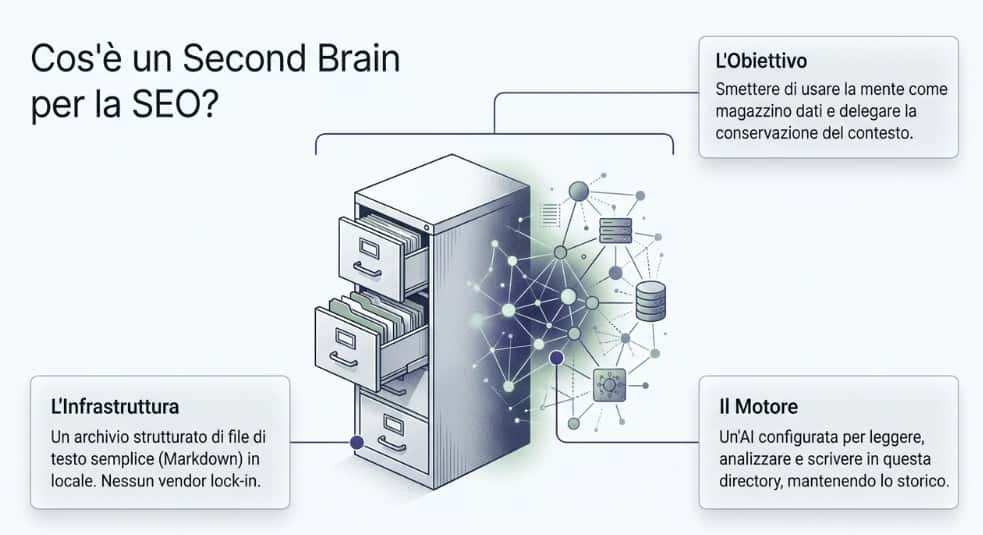
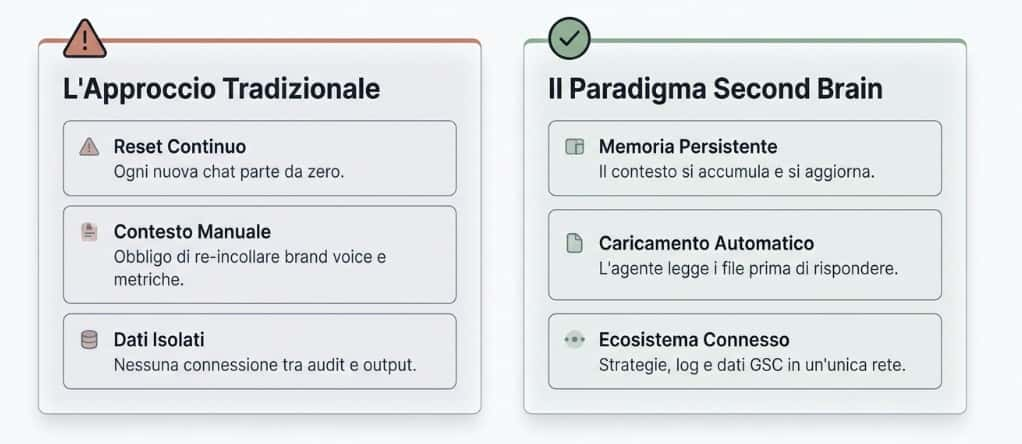
Il funzionamento di un Second Brain potenziato dall’intelligenza artificiale risolve uno dei limiti più grandi dei moderni modelli linguistici, ovvero il reset del contesto ad ogni nuova sessione di chat. Tradizionalmente, ad ogni interazione occorre rispiegare all’AI chi è l’azienda, qual è il tono di voce, quali sono gli obiettivi SEO e quali decisioni sono già state prese. Un Second Brain organizza la conoscenza in file di testo semplice, spesso in formato Markdown, memorizzati all’interno di una cartella o “vault” di proprietà dell’utente. Attraverso strumenti avanzati o agenti da terminale, l’intelligenza artificiale accede a questa cartella all’inizio di ogni sessione, leggendo la mappa dei progetti, le linee guida del brand e lo storico delle attività svolte.
L’intero ciclo operativo di questo sistema si sviluppa lungo quattro gesti fondamentali:
- catturare le informazioni senza sforzo;
- organizzarle in base alla loro utilità futura;
- ritrovarle mediante ricerche semantiche;
- rielaborarle per produrre nuova conoscenza.
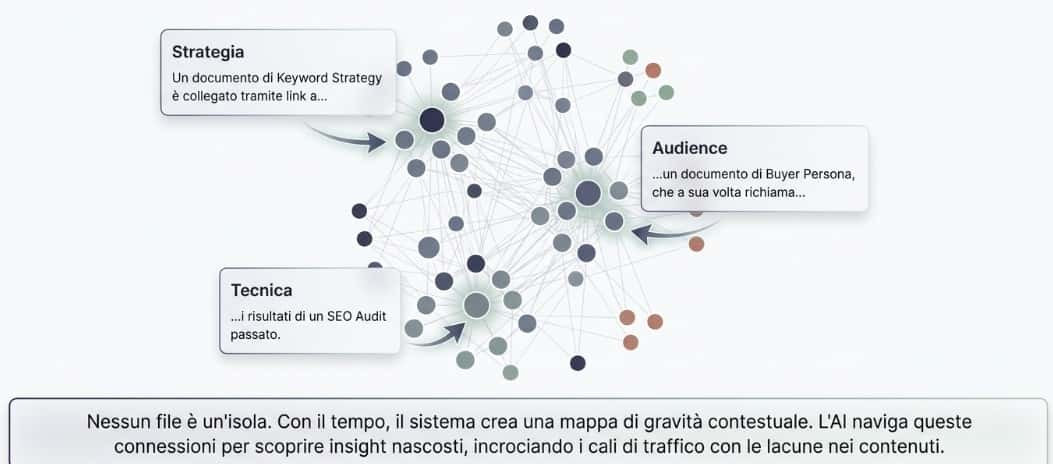
A differenza delle ricerche tradizionali per parole chiave esatte, l’integrazione di modelli linguistici permette di interrogare il proprio archivio per significato, consentendo all’AI di collegare appunti, audit passati e report di mesi diversi anche quando usano terminologie differenti. In questo modo, il Second Brain serve a trasformare un insieme slegato di dati in un collaboratore operativo capace di mantenere la memoria strategica del lavoro svolto.
I vantaggi concreti per la SEO e il Digital Marketing
Il tempo impiegato nella fase di configurazione rappresenta uno dei colli di bottiglia più frequenti. Costruire da zero fogli per gli audit tecnici, modelli per la mappatura delle parole chiave, brief per i redattori e tracciamenti delle deliverable ad ogni nuovo cliente crea un senso di rincorsa continua. Un Second Brain per la SEO permette di sviluppare template riutilizzabili e strutture di processo pronte all’uso, azzerando i tempi di avviamento dei progetti e garantendo standard operativi elevati.
Un ulteriore beneficio fondamentale risiede nel mantenimento di dati sempre aggiornati e pronti alla consultazione durante i briefing con gli stakeholder. Collegando il Second Brain alle fonti canoniche di un progetto, come gli export di Google Search Console, i dati sui ranking, la cronologia dei dati da Chrome DevTools per i Core Web Vitals o le analisi dei concorrenti, il sistema offre risposte basate su evidenze fresche anziché su fotogrammi vecchi di settimane. Quando si presenta la necessità di argomentare l’importanza di targettizzare parole chiave a basso volume o di mostrare l’impatto di un problema tecnico, il Second Brain consente di recuperare istantaneamente dati e casi di studio archiviati.
Inoltre, il Second Brain permette di svolgere un’analisi cross-progetto che sarebbe quasi impossibile da gestire a memoria. Interrogando il sistema su più domini gestiti, è possibile identificare se improvvisi cali di clic o anomalie nell’indicizzazione siano riconducibili a un aggiornamento algoritmico generale, a problemi di cannibalizzazione o a modifiche nei layout delle pagine dei risultati di ricerca. La produzione di contenuti e documenti strategici passa così da risposte generiche dell’AI a bozze fortemente contestualizzate, modellate sul vero storico del sito, sul suo catalogo e sulle direttive aziendali.
Quale piattaforma scegliere per creare un Second Brain?
La scelta della piattaforma per la costruzione di un SEO Second Brain non deve dipendere dalle mode tecnologiche del momento, bensì dall’allineamento tra le funzionalità del software e la propria modalità naturale di gestire le informazioni. Analizzando i diversi stili operativi definiti nel framework di Tiago Forte, si individuano quattro profili principali che guidano la selezione dello strumento ideale.
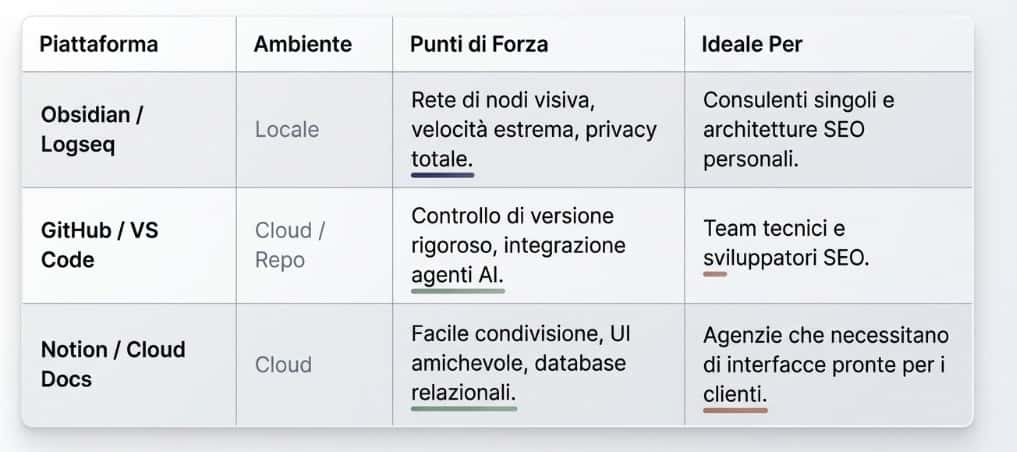
L’architetto predilige la strutturazione gerarchica dei dati e la gestione di progetti complessi, trovando in applicazioni come Notion o Craft l’ambiente perfetto per configurare database relazionali e spazi di lavoro articolati.
Il giardiniere prospera invece coltivando connessioni fluide ed esplorando relazioni tra concetti; per questo profilo, software basati su file locali di testo semplice in formato Markdown con collegamenti bidirezionali come Obsidian o Roam rappresentano la scelta d’elezione, consentendo sia all’utente che all’intelligenza artificiale di esplorare un vero e proprio grafo di conoscenza.
Il bibliotecario punta a raccogliere e curare risorse eterogenee da fonti esterne per la consultazione quotidiana, orientandosi verso strumenti come Evernote o Microsoft OneNote.
Infine, lo studente ricerca la massima semplicità operativa priva di frizioni o configurazioni iniziali, affidandosi ad applicazioni essenziali ed immediate come Apple Notes o Google Keep per la sola fase di cattura rapida.
Qualora il sistema debba successivamente evolvere verso la collaborazione in team o su scala aziendale, l’integrazione di repository centralizzati su GitHub consente di introdurre un controllo di versione formale sulle informazioni, confermando come la durabilità della conoscenza risieda nella qualità del contesto memorizzato e nella portabilità dei formati anziché nel singolo software adottato.
Guida pratica: come creare un SEO Second Brain con diverse tecnologie
La costruzione pratica di un Second Brain deve sempre partire dalle esigenze operative e dalla tipologia di organizzazione delle informazioni preferita dall’utente, evitando di impantanarsi nella scelta dello strumento perfetto.
Per un setup basato su file locali, la combinazione tra Obsidian e Claude Code rappresenta una delle architetture più solide e versatili. Obsidian memorizza i dati sul computer locale in file di testo Markdown, garantendo la totale proprietà delle informazioni senza vincoli di piattaforma e permettendo di creare collegamenti bidirezionali tra i concetti. Claude Code o altri agenti operano all’interno del terminale, accedendo direttamente a questi file per leggere e scrivere informazioni con memoria persistente tra le sessioni. Per chi lavora in team o necessita di database condivisi con interfacce collaborative, Notion costituisce un’alternativa eccellente, mentre l’uso di GitHub consente di introdurre un controllo di versione avanzato sulla conoscenza aziendale.
Per quanto riguarda la struttura interna delle cartelle, si possono adottare due metodologie principali perfettamente integrabili. La prima è il framework PARA, che suddivide lo spazio in quattro contenitori dinamici:
- Progetti, dedicati ai compiti imminenti legati a scadenze precise come l’ottimizzazione dei link interni di una landing page;
- Aree, dedicate alle responsabilità continue come la reportistica mensile;
- Risorse, incentrate su argomenti di interesse prolungato come le guide SEO o i dati dei buyer persona;
- Archivio, destinato a tutto ciò che è stato completato.
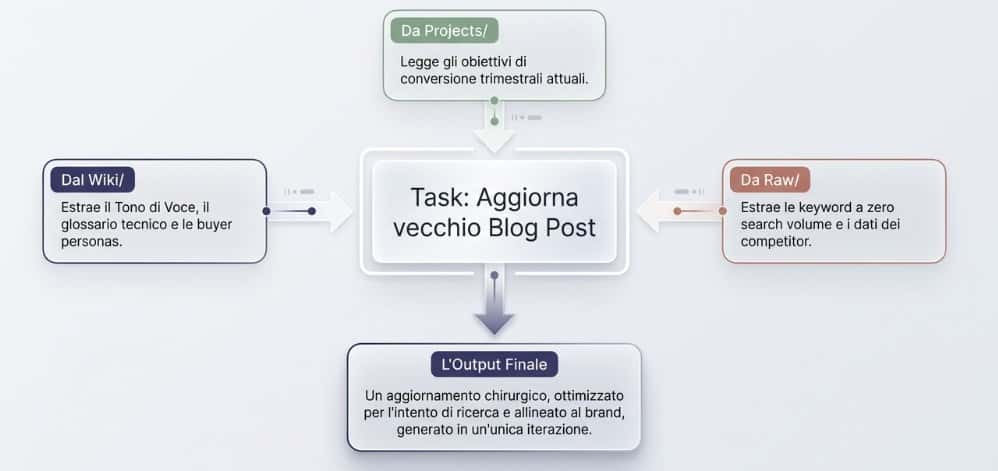
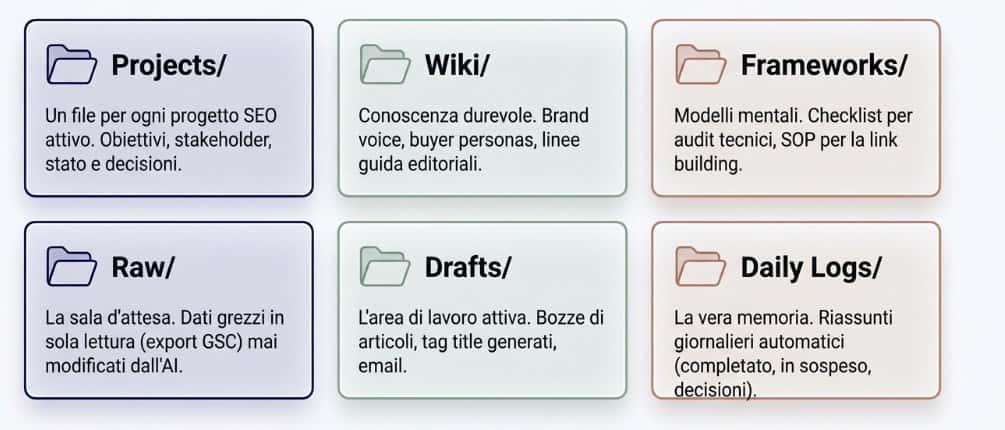
La seconda architettura, ispirata al modello Karpathy e rielaborata da Flanagan, organizza il vault in cartelle specifiche: la cartella Raw accoglie materiali grezzi non strutturati che l’AI legge ma non modifica mai; la cartella Wiki contiene la documentazione di riferimento durevole sviluppata dall’AI; la cartella Frameworks racchiude i modelli mentali e le procedure dell’agenzia; la cartella Drafts raccoglie i documenti generati; la cartella Daily Logs memorizza i riassunti giornalieri delle sessioni.
Al centro di questa architettura risiede il file di configurazione radice, denominato CLAUDE.md. Questo file costituisce la vera e propria costituzione del Second Brain: definisce l’identità dell’operatore, le regole di scrittura, la struttura delle cartelle, le convenzioni di nomenclatura, i framework SEO da seguire rigorosamente e le istruzioni che l’agente AI deve caricare ad ogni avvio prima di eseguire qualsiasi compito.
Come implementare il Second Brain nella routine SEO
L’adozione di un SEO Second Brain richiede una disciplina operativa in grado di trasformare un semplice archivio digitale in una memoria organizzata, persistente e interrogabile. Per evitare che l’infrastruttura degradi in una raccolta inerte di documenti, è indispensabile implementare flussi di lavoro strutturati per l’acquisizione, la gestione quotidiana e la manutenzione periodica, prevenendo al contempo gli errori metodologici più frequenti.
Il primo passaggio procedurale consiste nello stabilire un punto d’ingresso unico e immediato, definito stazione di cattura. Sia su ambienti desktop che su dispositivi mobili, la registrazione di un articolo tecnico, di un aggiornamento algoritmico o delle note di un meeting deve richiedere pochissimi secondi. Questa cartella d’ingresso provvisoria raccoglie i materiali grezzi in attesa di collocazione, riducendo a zero la fatica cognitiva nel momento dell’acquisizione.
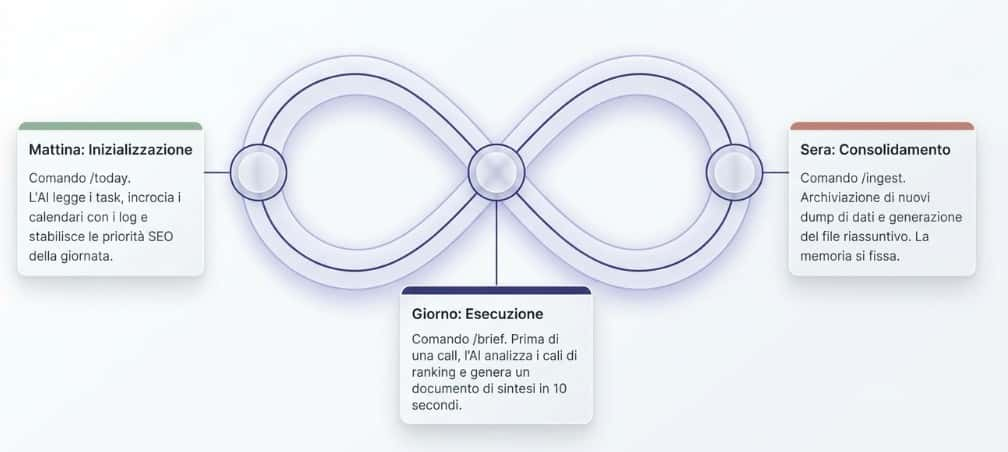
L’integrazione del sistema nel lavoro quotidiano si articola attraverso un ciclo operativo distribuito in quattro fasi chiave.
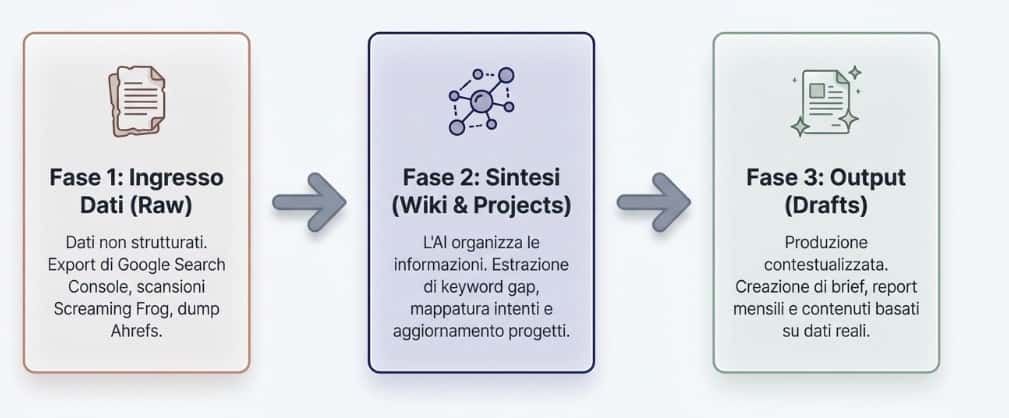
Al mattino, la sessione di pianificazione esamina il calendario e le scadenze dei progetti attivi, organizzando la giornata con una netta priorità per i blocchi di lavoro profondo dedicati ad analisi e strategie, e riservando i blocchi brevi alle attività operative di routine.
Prima di ogni riunione o chiamata con i clienti, l’esecuzione di un comando di briefing genera una sintesi immediata dello stato del posizionamento del sito, delle metriche rilevate e dei punti ancora aperti.
Durante la giornata lavorativa, qualsiasi nuova priorità o anomalia rilevata durante gli audit viene registrata tempestivamente nel sistema senza interrompere il flusso d’analisi.
Infine, al termine della giornata, una procedura di chiusura della durata di cinque minuti riconcilia le attività completate e genera un riassunto strutturato nella cartella dei log giornalieri, garantendo che la sessione dell’indomani riparta con la memoria completa del contesto precedente.
A livello settimanale, la procedura richiede un rito di manutenzione di quindici minuti finalizzato a svuotare la cartella delle entrate grezze, aggiornare l’infrastruttura con i dati freschi provenienti da Google Search Console e dagli strumenti di tracciamento, e archiviare la documentazione dei progetti conclusi.
Rischi ed errori nel Second Brain a cui fare attenzione
Il rischio principale nella gestione di un Second Brain è l’accumulo incontrollato di informazioni, noto come collezionismo digitale. Salvare centinaia di articoli, report o file PDF senza aggiungere una rielaborazione personale trasforma il sistema in un archivio rumoroso e inutilizzabile. Per preservare il valore dell’informazione, ogni appunto deve essere accompagnato da almeno una nota sintetica dell’utente che ne espliciti il contesto, la motivazione del salvataggio e l’applicazione pratica per un determinato progetto.
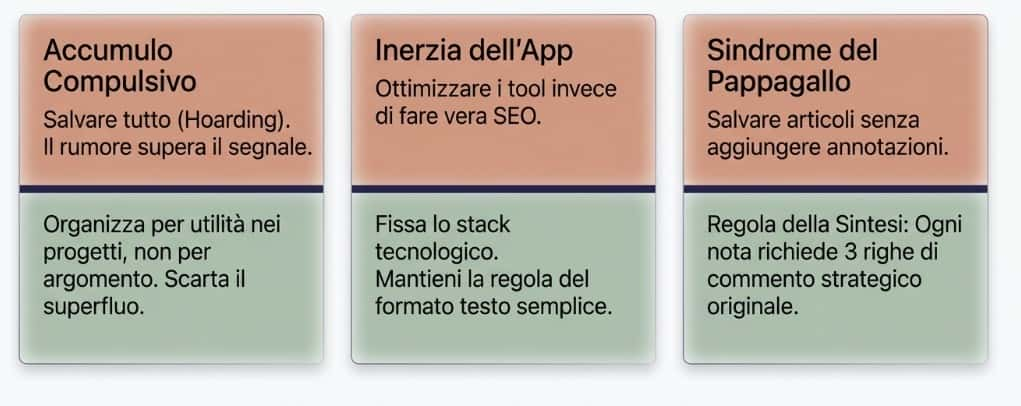
Un secondo errore risiede nella sovra-ingegnerizzazione iniziale della struttura. Progettare architetture articolate o dozzine di agenti specializzati prima di aver accumulato contenuti reali genera un inutile sovraccarico gestionale; la prassi corretta prevede di iniziare da tre o quattro progetti operativi e far evolvere il sistema attorno ad essi. In questo contesto, è fondamentale mantenere la cartella delle fonti grezze rigorosamente in sola lettura, impedendo ai modelli linguistici di sovrascrivere o alterare i documenti originali durante i processi di sintesi automatica.
Occorre inoltre evitare la sindrome della riorganizzazione continua, caratterizzata dal costante cambio di applicazioni ad ogni novità tecnologica, fenomeno che azzera le abitudini operative e disperde il patrimonio informativo. Da ultimo, è essenziale evitare la fiducia cieca negli output generati dall’intelligenza artificiale. Quando le informazioni servono per decisioni strategiche o per la reportistica destinata agli stakeholder, si deve esigere che l’assistente indichi sempre la fonte esatta da cui ha estratto il dato, mantenendo una rigorosa validazione umana prima di ogni esecuzione.
Suggerimenti di miglioramento progressivo nella creazione di un secondo cervello
Per far crescere il Second Brain senza rimanerne sopraffatti, il miglioramento deve avvenire per fasi successive. Si parte con la semina di un singolo progetto attivo, inserendo nella cartella dei materiali grezzi gli audit passati, gli export delle keyword e la strategia iniziale, per poi chiedere al sistema di sintetizzare il file di progetto. Una volta consolidata l’abitudine di salvare i log giornalieri a fine sessione, si possono integrare comandi automatici e script di analisi più complessi.
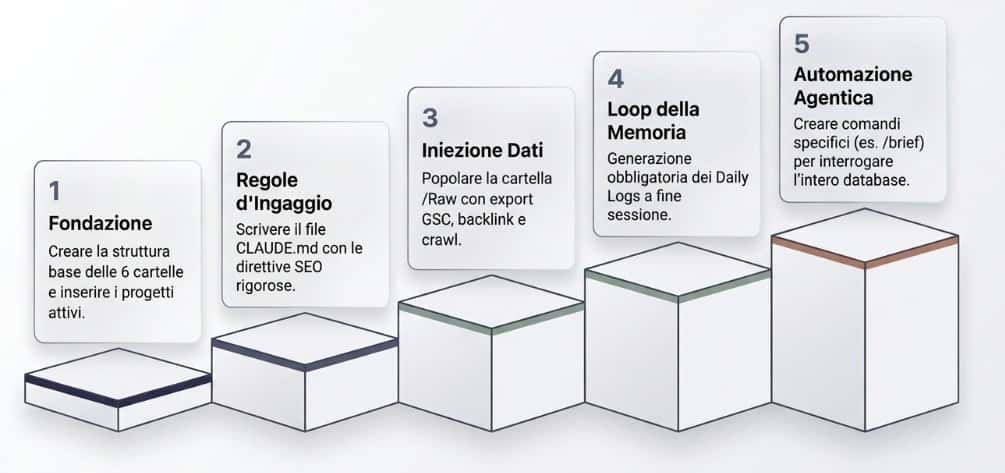
A cadenza periodica, è utile eseguire una procedura di controllo e manutenzione del sistema. Questa verifica scandaglia i file per identificare eventuali contraddizioni tra dati citati in documenti diversi, segnalare statistiche o posizioni SEO non aggiornate da oltre sessanta giorni, individuare pagine orfane prive di collegamenti e sintetizzare concetti ricorrenti che meritano una nota dedicata.
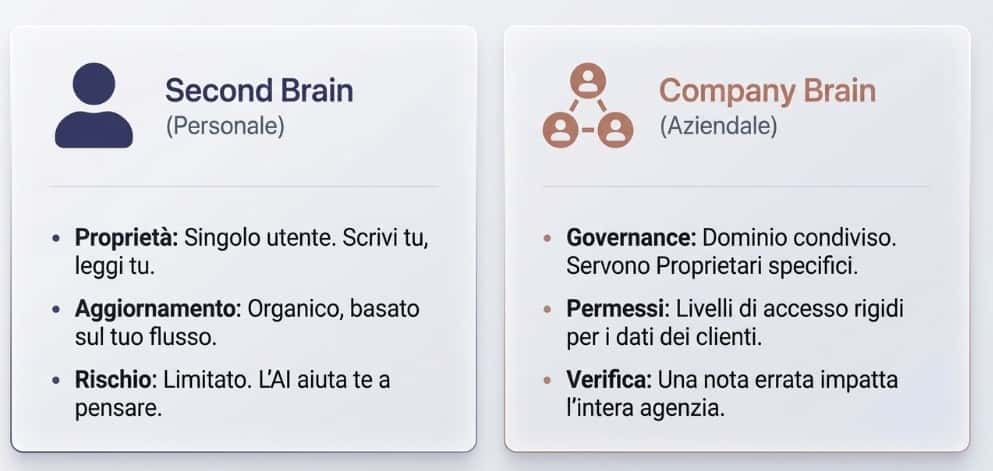
Quando il Second Brain individuale dimostra la sua efficacia e la conoscenza deve essere condivisa con colleghi o reparti dell’agenzia, il sistema compie il salto verso un Company Brain aziendale. In questo scenario, le informazioni non appartengono più a una sola persona ma diventano la memoria dell’intera organizzazione, garantendo la continuità operativa anche in caso di avvicendamento del personale. Per passare al Company Brain occorre definire con chiarezza quattro elementi cardine:
- la proprietà di ogni area, assegnando un responsabile che garantisca la veridicità delle note;
- la gestione dei permessi di lettura, affinché i dati sensibili o i contratti dei clienti siano visibili solo a chi ne ha il diritto;
- una regola di revisione programmata per impedire che le procedure invecchino;
- la presenza inderogabile di un supervisore umano prima che l’AI compia azioni direttamente verso clienti o mercati esterni.
Come creare un Second Brain con Claude – Istruzioni
Ecco la procedura pratica passo dopo passo per creare un SEO Second Brain integrando Obsidian (per l’archiviazione locale delle note in formato Markdown) e Claude Code (come agente AI operante da terminale con accesso diretto alle note):
Step 1: Creare lo Spazio di Lavoro e le Sottocartelle
Creare una cartella principale (Vault) sul computer locale all’interno di Obsidian. Per garantire che l’AI sappia dove leggere e scrivere senza sovrascrivere dati critici, la struttura delle sottocartelle deve essere organizzata come segue:
- Projects/: contiene un file Markdown per ciascun progetto o cliente attivo (obiettivi, stakeholder, stato attuale e decisioni aperte).
- Wiki/: raccoglie la documentazione di riferimento duratura (linee guida del brand, buyer persona, posizionamento ed esempi di scrittura).
- Frameworks/: memorizza le procedure agenziali, i modelli mentali e le metodologie d’analisi SEO.
- Raw/: destinata ai materiali grezzi non strutturati (export GSC, audit passati, file PDF, trascrizioni) ed è mantenuta in sola lettura.
- Drafts/: accoglie gli elaborati generati dall’AI prima della revisione (bozze di articoli, brief, report).
- Daily Logs/: ospita i riassunti automatici di fine sessione per garantire la persistenza della memoria.
Step 2: Configurare la “Costituzione” del Sistema (CLAUDE.md)
Nella radice (root) del Vault occorre creare un file di configurazione denominato CLAUDE.md. Questo file rappresenta la direttiva primaria che Claude Code carica automaticamente all’avvio di ogni sessione prima di eseguire qualsiasi compito.
All’interno di CLAUDE.md vanno definiti:
- Contesto e ruolo: chi sei, i clienti gestiti e la struttura del lavoro.
- Mappa dell’infrastruttura: spiegazione dell’organizzazione delle cartelle.
- Regole operative severe: istruzioni vincolanti (ad esempio “Non sovrascrivere mai una nota esistente senza autorizzazione” o “Mantieni la cartella Raw in sola lettura”).
- Convenzioni SEO: linee guida di formattazione e regole per i report.
Step 3: Alimentare il Sistema con i Progetti Attivi (Seeding)
Anziché importare anni di storico in una sola volta, si parte con i 3-5 progetti primari:
- Caricare i documenti esistenti del cliente (audit tecnici, export Ahrefs/GSC, brief) nella cartella Raw/.
- Tramite terminale, lanciare il comando di popolamento (ad esempio /project new <nome-cliente>).
- Claude Code analizzerà i materiali grezzi, estrarrà obiettivi, parole chiave e criticità, e genererà un unico file di progetto strutturato nella cartella Projects/, citando la fonte originale di ogni dato.
Step 4: Connettere Claude Code e Testare il Flusso
- Aprire il terminale nella cartella del Vault ed eseguire Claude Code.
- All’avvio, l’agente caricherà il file CLAUDE.md e l’indice dei progetti, acquisendo l’intero contesto prima che tu scriva il primo prompt.
- Eseguire un test di verifica: chiedere a Claude di sintetizzare lo stato di un progetto attivo, identificare le ultime decisioni e proporre le azioni successive basandosi sulle note del Vault. Se le risposte risultano generiche o imprecise, affinare le istruzioni in CLAUDE.md prima di procedere.
Step 5: Attivare la Memoria Persistente tramite i Log Giornalieri
Per evitare che l’AI dimentichi il contesto alla chiusura della finestra di lavoro, si imposta il ciclo dei log quotidiani:
- Procedura di chiusura (/shutdown): a fine giornata, l’agente genera un file datato in Daily Logs/ registrando compiti completati, modifiche e task sospese.
- Procedura di avvio (/today): all’avvio della sessione successiva, l’agente legge i log recenti e i file di progetto, riprendendo il lavoro esattamente da dove era stato interrotto.
Step 6: Automazione dei Flussi con Comandi e Agenti
Una volta stabilizzata la struttura, si possono creare ruoli e comandi ricorrenti:
- Comandi rapidi: istruzioni fisse come /brief [cliente] prima delle chiamate con i clienti per ottenere una sintesi delle metriche e dei punti aperti, oppure /lint per scansionare il Vault e individuare contraddizioni o dati obsoleti oltre i 60 giorni.
- Agenti e Skills: configurare agenti specializzati ancorati alle note (ad esempio un agente Copywriter che scrive basandosi sulle guide in Wiki/, o un agente di QA Reviewer che verifica i fatti rispetto alle fonti in Raw/).
Post simili:
 Guida a Claude per la SEO
 Guida a NotebookLM per la SEO
 Guida alla SEO per i Brand
 Guida a Screaming Frog per la SEO Audit
 In Che Modo l’IA Generativa Impatta sulla SEO?
 SEO come Strategia d’Impresa: le Tecniche Avanzate che non Conosci
 Come Recuperare le Posizioni Perse su Google?
 100 Tool Gratis e Freemium per Copywriter SEO
 Neon Genesis Evangelion: Analisi dei personaggi
 Guida a WP-Rocket per la SEO






Leave a Reply